Inteligência artificial executada em console clássico do Super Nintendo
 Por Arthur Bittencourt ·
Execução local de inteligência artificial em hardware retrô
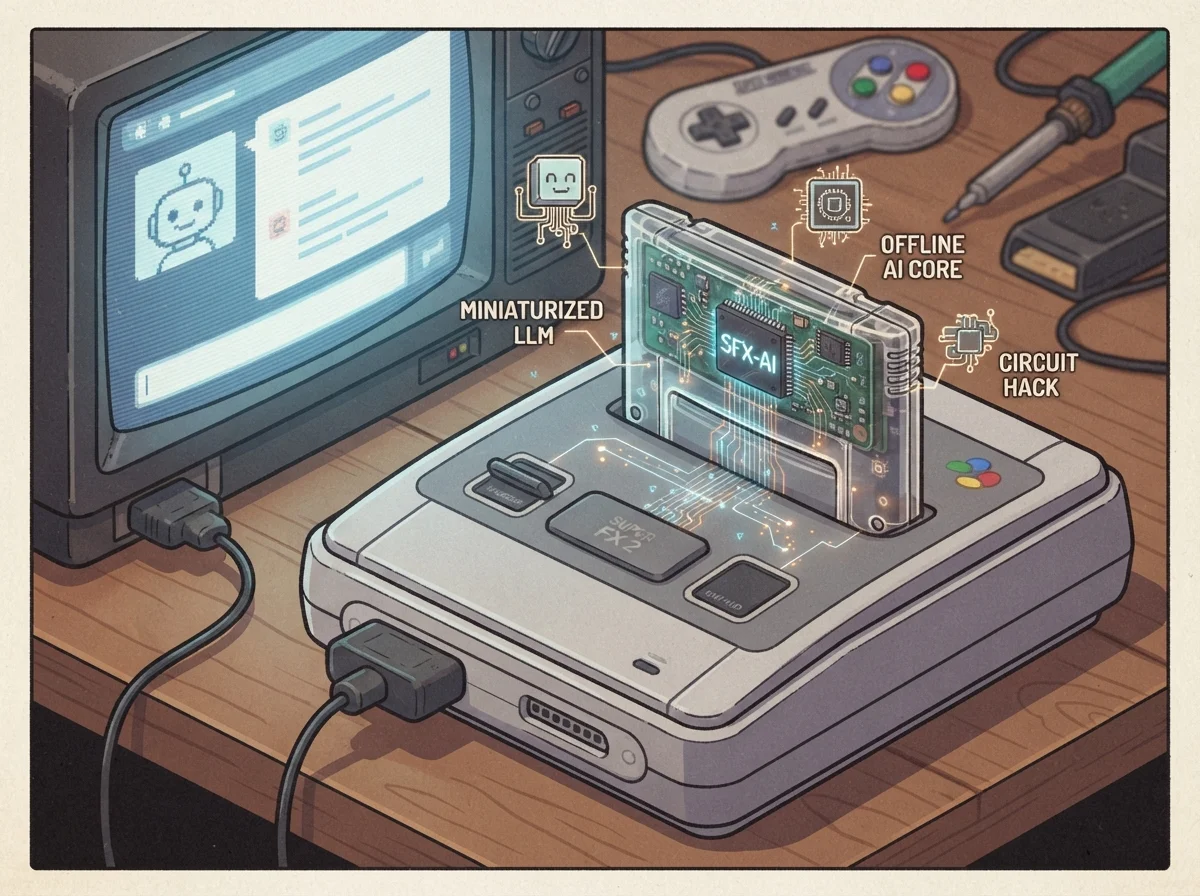
O desenvolvedor Benj Edwards, criador da plataforma Vintage Computing, demonstrou que é possível executar um modelo de linguagem funcional diretamente no hardware do Super Nintendo (SNES), sem a necessidade de qualquer conexão com a internet ou servidores externos. O projeto utiliza o coprocessador Super FX 2 para processar as interações de um chatbot inspirado no ChatGPT, permitindo que o videogame de 1990 atue como um terminal de conversação autônomo.
Essa descoberta é relevante porque ilustra os limites extremos da compressão de modelos de linguagem e a viabilidade de tecnologias "edge", onde o processamento ocorre na própria ponta, no dispositivo final do usuário. Em um cenário onde a maioria das pessoas depende de grandes centros de dados para acessar ferramentas de IA, este experimento prova que até componentes eletrônicos obsoletos possuem capacidade computacional suficiente se o software for adequadamente otimizado para lidar com restrições severas de memória e velocidade de clock.
Arquitetura técnica por trás do chat offline
Para tornar isso possível, foi utilizado o chip Super FX 2, um componente desenvolvido originalmente pela Silicon Graphics para auxiliar o console em tarefas matemáticas complexas, como renderização 3D básica. Ele opera a uma frequência de 21,47 MHz, o que exige um modelo de inteligência artificial extremamente enxuto. Edwards utilizou um pequeno modelo de linguagem composto por apenas 2,2 milhões de parâmetros — entenda "parâmetros" como as conexões neurais artificiais que determinam como a máquina responde; imagine-os como pequenas chaves de ajuste que definem o tom e a direção de uma frase.
O treinamento deste modelo específico baseou-se em conversações geradas pelo gpt-oss-120b da OpenAI. No entanto, devido à limitação do hardware antigo, a escala é drasticamente reduzida: enquanto modelos modernos operam com bilhões ou trilhões de parâmetros, esta versão precisa ser milhares de vezes menor para caber no sistema. O resultado dessa compressão permite gerar aproximadamente duas unidades de texto por segundo, uma velocidade lenta comparada aos padrões atuais, mas tecnicamente significativa dado o contexto histórico do processador envolvido.
Experiência do usuário e versões disponíveis
Atualmente, o experimento pode ser testado através de um emulador web utilizando o Snes9x, onde os usuários interagem via teclado. Existem dois níveis de complexidade para esse projeto: uma versão básica de 4 MB, que contém puramente a lógica do modelo de linguagem, e uma versão expandida de 19 MB. Esta segunda opção integra informações extraídas de cerca de 150 mil artigos da Wikipédia adaptados para inglês simplificado, permitindo que a IA tenha acesso a um maior volume de fatos antes de formular respostas ao usuário.
Para quem possui o console físico original, o software também pode ser executado via cartuchos flash compatíveis com o chip Super FX 2 e, na versão ampliada, com o chip MSU-1, que auxilia no gerenciamento de memória adicional. A interface mantém a estética retrô característica dos anos 1990, incluindo efeitos sonoros clássicos e trilhas musicais em estilo chiptune (música composta especificamente pelos chips de som de consoles antigos), unificando a experiência visual e auditiva à nova funcionalidade tecnológica.
Limitações do sistema e comparação com modelos modernos
É importante destacar que esta implementação não substitui as capacidades das versões modernas do ChatGPT ou Gemini. Por possuir poucos parâmetros, o chatbot tende a oferecer respostas muito simples e frequentemente produz falas absurdas ou incoerentes devido à falta de "espaço mental" computacional para processar nuances complexas. Diferente dos sistemas atuais que analisam contextos vastos simultaneamente, este modelo opera mais como um preenchimento automático altamente sofisticado do que como uma assistente inteligente capaz de resolver problemas multifacetados.
Comparando com os padrões atuais, onde modelos são rodados em GPUs potentes capazes de gerenciar bilhões de operações por segundo, a versão SNES é um exercício de engenharia focada em miniaturização radical. Ela serve menos como uma ferramenta de produtividade prática e mais como uma prova de conceito sobre a modularidade da inteligência artificial. O experimento demonstra que, se sacrificarmos precisão e velocidade, podemos portar funções cognitivas básicas para qualquer hardware que tenha capacidade mínima de processamento lógico.
Perspectivas futuras para IA em dispositivos limitados
A longo prazo, esse tipo de desenvolvimento sinaliza uma tendência crescente na busca por privacidade e eficiência: a execução de IAs locais em pequenos dispositivos eletrônicos sem necessidade de nuvem. À medida que as técnicas de quantização (o processo de reduzir a precisão numérica das redes neurais para economizar memória) evoluem, poderemos ver versões funcionais de assistentes integradas em eletrodomésticos ou wearables antigos, operando totalmente offline. Por enquanto, o projeto de Ben Edwards permanece como uma curiosidade técnica fascinante e uma lição de otimização extrema.