Künstliche Intelligenz, ausgeführt auf einer klassischen Super Nintendo Konsole
Por Arthur Bittencourt ·
Lokale Ausführung von Künstlicher Intelligenz auf Retro-Hardware
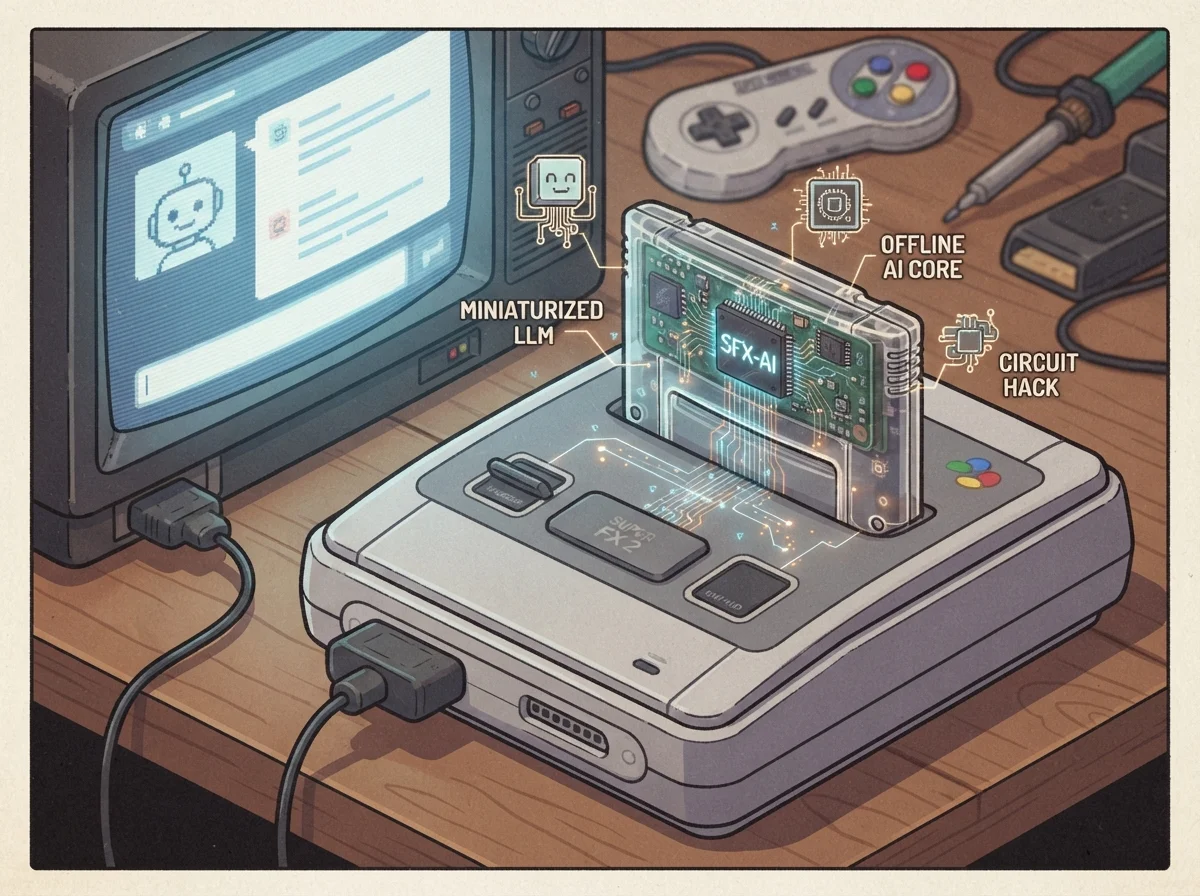
Der Entwickler Benj Edwards, Gründer der Plattform Vintage Computing, hat gezeigt, dass es möglich ist, ein funktionierendes Sprachmodell direkt auf der Hardware des Super Nintendo (SNES) auszuführen, ohne jegliche Internet- oder externen Serververbindung. Das Projekt nutzt den Coprozessor Super FX 2, um die Interaktionen eines Chatbots, der vom ChatGPT inspiriert ist, zu verarbeiten und ermöglicht so, dass die Videospielkonsole von 1990 als autonomer Konversations-Terminal fungiert.
Diese Entdeckung ist relevant, weil sie die extremen Grenzen der Sprachmodellkompression und die Machbarkeit von „Edge“-Technologien veranschaulicht, bei denen die Verarbeitung direkt an der Quelle, auf dem Endgerät des Benutzers, stattfindet. In einem Szenario, in dem die meisten Menschen für den Zugriff auf KI-Tools auf große Rechenzentren angewiesen sind, beweist dieses Experiment, dass selbst veraltete elektronische Komponenten über genügend Rechenleistung verfügen, wenn die Software angemessen optimiert ist, um strenge Einschränkungen bei Speicher und Taktfrequenz zu bewältigen.
Die technische Architektur hinter dem Offline-Chat
Um dies zu ermöglichen, wurde der Chip Super FX 2 verwendet, eine Komponente, die ursprünglich von Silicon Graphics entwickelt wurde, um die Konsole bei komplexen mathematischen Aufgaben wie grundlegender 3D-Renderung zu unterstützen. Er arbeitet mit einer Frequenz von 21,47 MHz, was ein extrem schlankes KI-Modell erfordert. Edwards nutzte ein kleines Sprachmodell, das nur aus 2,2 Millionen Parametern besteht – verstehen Sie „Parameter“ als die künstlichen neuronalen Verbindungen, die bestimmen, wie die Maschine antwortet; stellen Sie sie sich wie kleine Einstellschalter vor, die den Ton und die Richtung eines Satzes definieren.
Das Training dieses spezifischen Modells basierte auf Gesprächen, die von gpt-oss-120b von OpenAI generiert wurden. Aufgrund der Einschränkungen der alten Hardware ist die Skalierung jedoch drastisch reduziert: Während moderne Modelle mit Milliarden oder Billionen von Parametern arbeiten, muss diese Version tausende Male kleiner sein, um in das System zu passen. Das Ergebnis dieser Kompression ermöglicht die Generierung von etwa zwei Text-Einheiten pro Sekunde, eine langsame Geschwindigkeit im Vergleich zu aktuellen Standards, aber technisch signifikant angesichts des historischen Kontextes des beteiligten Prozessors.
Benutzererfahrung und verfügbare Versionen
Der Versuch kann derzeit über einen Web-Emulator mit Snes9x getestet werden, wobei die Benutzer über die Tastatur interagieren. Für dieses Projekt gibt es zwei Komplexitätsstufen: eine Basisversion von 4 MB, die rein die Logik des Sprachmodells enthält, und eine erweiterte Version von 19 MB. Diese zweite Option integriert Informationen aus etwa 150.000 Artikeln der Wikipédia, die für einfaches Englisch adaptiert wurden, wodurch die KI Zugriff auf ein größeres Faktenvolumen erhält, bevor sie Antworten an den Benutzer formuliert.
Für diejenigen, die die originale physische Konsole besitzen, kann die Software auch über Flash-Cartridges ausgeführt werden, die mit dem Chip Super FX 2 kompatibel sind, und in der erweiterten Version mit dem Chip MSU-1, der bei der Verwaltung zusätzlichen Speichers hilft. Die Benutzeroberfläche behält die charakteristische Retro-Ästhetik der 1990er Jahre bei, einschließlich klassischer Soundeffekte und Chiptune-Musik (Musik, die speziell von den Soundchips alter Konsolen komponiert wurde), wodurch das visuelle und auditive Erlebnis mit der neuen technologischen Funktionalität vereint wird.
Systembeschränkungen und Vergleich mit modernen Modellen
Es ist wichtig zu betonen, dass diese Implementierung die Fähigkeiten moderner Versionen von ChatGPT oder Gemini nicht ersetzt. Da das Chatbot nur wenige Parameter besitzt, neigt es dazu, sehr einfache Antworten zu liefern und produziert häufig unsinnige oder inkohärente Ausgaben, da ihm die "kognitive Kapazität" fehlt, komplexe Nuancen zu verarbeiten. Im Gegensatz zu aktuellen Systemen, die riesige Kontexte gleichzeitig analysieren, funktioniert dieses Modell eher als hochkomplexer Autocomplete-Mechanismus denn als intelligenter Assistent, der multifacettierte Probleme lösen kann.
Im Vergleich zu aktuellen Standards, bei denen Modelle auf leistungsstarken GPUs laufen, die Milliarden von Operationen pro Sekunde verarbeiten können, ist die SNES-Version eine Ingenieursübung, die auf radikaler Miniaturisierung basiert. Sie dient weniger als praktisches Produktivitätswerkzeug als vielmehr als Proof of Concept für die Modularität der künstlichen Intelligenz. Das Experiment demonstriert, dass wir, wenn wir Präzision und Geschwindigkeit opfern, grundlegende kognitive Funktionen auf jede Hardware portieren können, die über eine minimale logische Verarbeitungskapazität verfügt.
Zukünftige Perspektiven für KI auf limitierten Geräten
Langfristig signalisiert diese Art von Entwicklung einen wachsenden Trend zur Suche nach Privatsphäre und Effizienz: die Ausführung lokaler KIs auf kleinen elektronischen Geräten ohne Notwendigkeit einer Cloud. Wenn die Quantisierungstechniken (der Prozess, die numerische Präzision neuronaler Netze zu reduzieren, um Speicher zu sparen) fortschreiten, könnten wir funktionierende Versionen von Assistenten sehen, die in alten Haushaltsgeräten oder Wearables integriert sind und vollständig offline arbeiten. Im Moment bleibt das Projekt von Ben Edwards eine faszinierende technische Kuriosität und eine Lektion in extremer Optimierung.