Inteligencia artificial ejecutada en consola clásica de Super Nintendo
Por Arthur Bittencourt ·
Ejecución local de inteligencia artificial en hardware retro
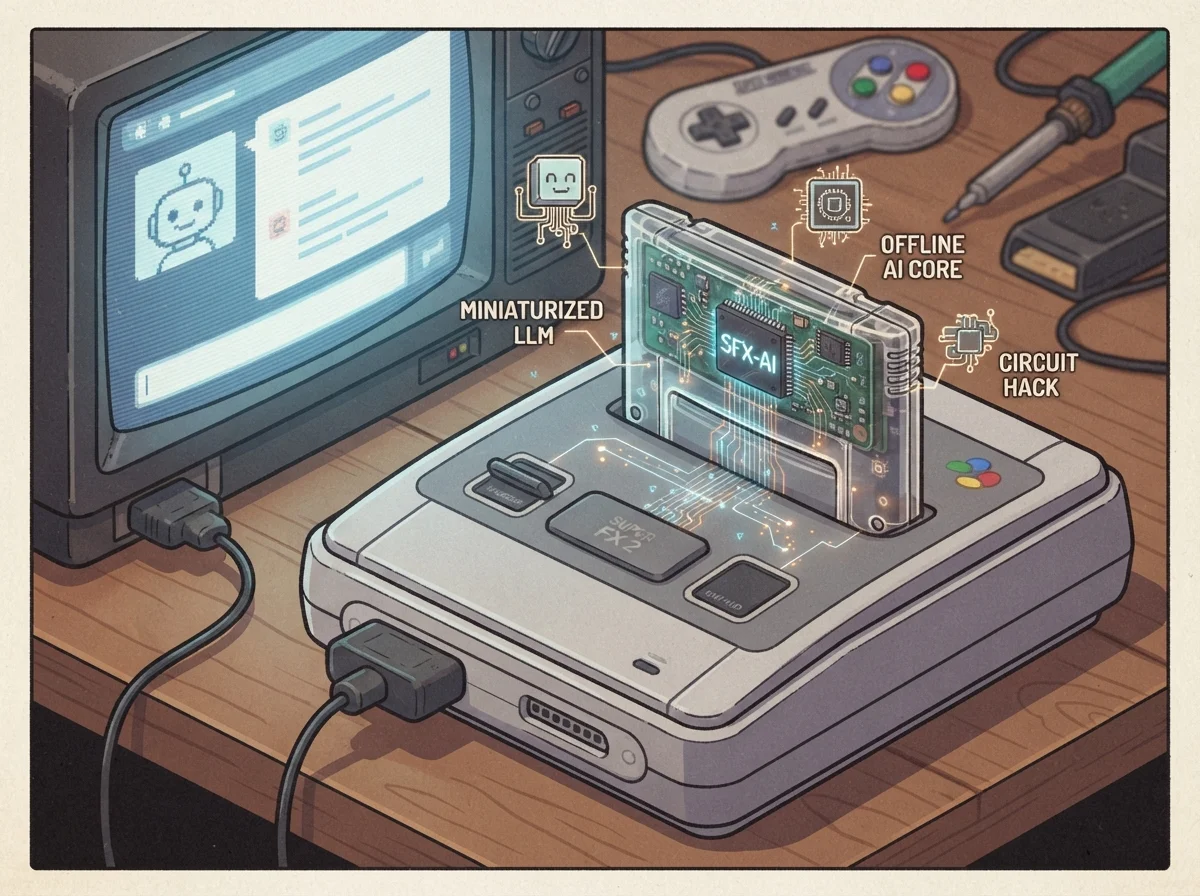
El desarrollador Benj Edwards, creador de la plataforma Vintage Computing, demostró que es posible ejecutar un modelo de lenguaje funcional directamente en el hardware de Super Nintendo (SNES), sin necesidad de ninguna conexión a internet o servidores externos. El proyecto utiliza el coprocesador Super FX 2 para procesar las interacciones de un chatbot inspirado en ChatGPT, permitiendo que el videojuego de 1990 actúe como un terminal de conversación autónomo.
Este descubrimiento es relevante porque ilustra los límites extremos de la compresión de modelos de lenguaje y la viabilidad de tecnologías "edge", donde el procesamiento ocurre en la propia punta, en el dispositivo final del usuario. En un escenario donde la mayoría de las personas depende de grandes centros de datos para acceder a herramientas de IA, este experimento prueba que incluso los componentes electrónicos obsoletos poseen capacidad computacional suficiente si el software está adecuadamente optimizado para manejar severas restricciones de memoria y velocidad de reloj.
Arquitectura técnica detrás del chat offline
Para hacer esto posible, se utilizó el chip Super FX 2, un componente desarrollado originalmente por Silicon Graphics para auxiliar la consola en tareas matemáticas complejas, como la renderización 3D básica. Opera a una frecuencia de 21,47 MHz, lo que exige un modelo de inteligencia artificial extremadamente compacto. Edwards utilizó un pequeño modelo de lenguaje compuesto por solo 2,2 millones de parámetros: entiende "parámetros" como las conexiones neuronales artificiales que determinan cómo responde la máquina; imagínalos como pequeños interruptores de ajuste que definen el tono y la dirección de una frase.
El entrenamiento de este modelo específico se basó en conversaciones generadas por gpt-oss-120b de OpenAI. Sin embargo, debido a la limitación del hardware antiguo, la escala se reduce drásticamente: mientras que los modelos modernos operan con miles de millones o billones de parámetros, esta versión debe ser miles de veces más pequeña para caber en el sistema. El resultado de esta compresión permite generar aproximadamente dos unidades de texto por segundo, una velocidad lenta comparada con los estándares actuales, pero técnicamente significativa dado el contexto histórico del procesador involucrado.
Experiencia de usuario y versiones disponibles
Actualmente, el experimento puede probarse a través de un emulador web utilizando Snes9x, donde los usuarios interactúan mediante teclado. Hay dos niveles de complejidad para este proyecto: una versión básica de 4 MB, que contiene puramente la lógica del modelo de lenguaje, y una versión expandida de 19 MB. Esta segunda opción integra información extraída de cerca de 150 mil artículos de Wikipedia adaptados a inglés simplificado, permitiendo que la IA tenga acceso a un mayor volumen de hechos antes de formular respuestas al usuario.
Para quienes poseen la consola física original, el software también puede ejecutarse mediante cartuchos flash compatibles con el chip Super FX 2 y, en la versión ampliada, con el chip MSU-1, que ayuda en la gestión de memoria adicional. La interfaz mantiene la estética retro característica de los años 90, incluyendo efectos de sonido clásicos y bandas sonoras en estilo chiptune (música compuesta específicamente por los chips de sonido de consolas antiguas), unificando la experiencia visual y auditiva con la nueva funcionalidad tecnológica.
Limitaciones del sistema y comparación con modelos modernos
Es importante destacar que esta implementación no sustituye las capacidades de las versiones modernas de ChatGPT o Gemini. Al poseer pocos parámetros, el chatbot tiende a ofrecer respuestas muy simples y frecuentemente produce falas absurdas o incoherentes debido a la falta de "espacio mental" computacional para procesar matices complejos. A diferencia de los sistemas actuales que analizan contextos vastos simultáneamente, este modelo opera más como un autocompletar altamente sofisticado que como un asistente inteligente capaz de resolver problemas multifacéticos.
Comparado con los estándares actuales, donde los modelos se ejecutan en GPUs potentes capaces de gestionar miles de millones de operaciones por segundo, la versión SNES es un ejercicio de ingeniería centrado en la miniaturización radical. Sirve menos como una herramienta de productividad práctica y más como una prueba de concepto sobre la modularidad de la inteligencia artificial. El experimento demuestra que, si sacrificamos precisión y velocidad, podemos portar funciones cognitivas básicas a cualquier hardware que tenga capacidad mínima de procesamiento lógico.
Perspectivas futuras para la IA en dispositivos limitados
A largo plazo, este tipo de desarrollo señala una tendencia creciente en la búsqueda de privacidad y eficiencia: la ejecución de IAs locales en pequeños dispositivos electrónicos sin necesidad de la nube. A medida que las técnicas de cuantización (el proceso de reducir la precisión numérica de las redes neuronales para ahorrar memoria) evolucionen, podremos ver versiones funcionales de asistentes integrados en electrodomésticos o wearables antiguos, operando totalmente offline. Por ahora, el proyecto de Ben Edwards sigue siendo una curiosidad técnica fascinante y una lección de optimización extrema.