Super Nintendoのクラシックなコンソールで実行される人工知能
Por Arthur Bittencourt ·
レトロハードウェア上での人工知能のローカル実行
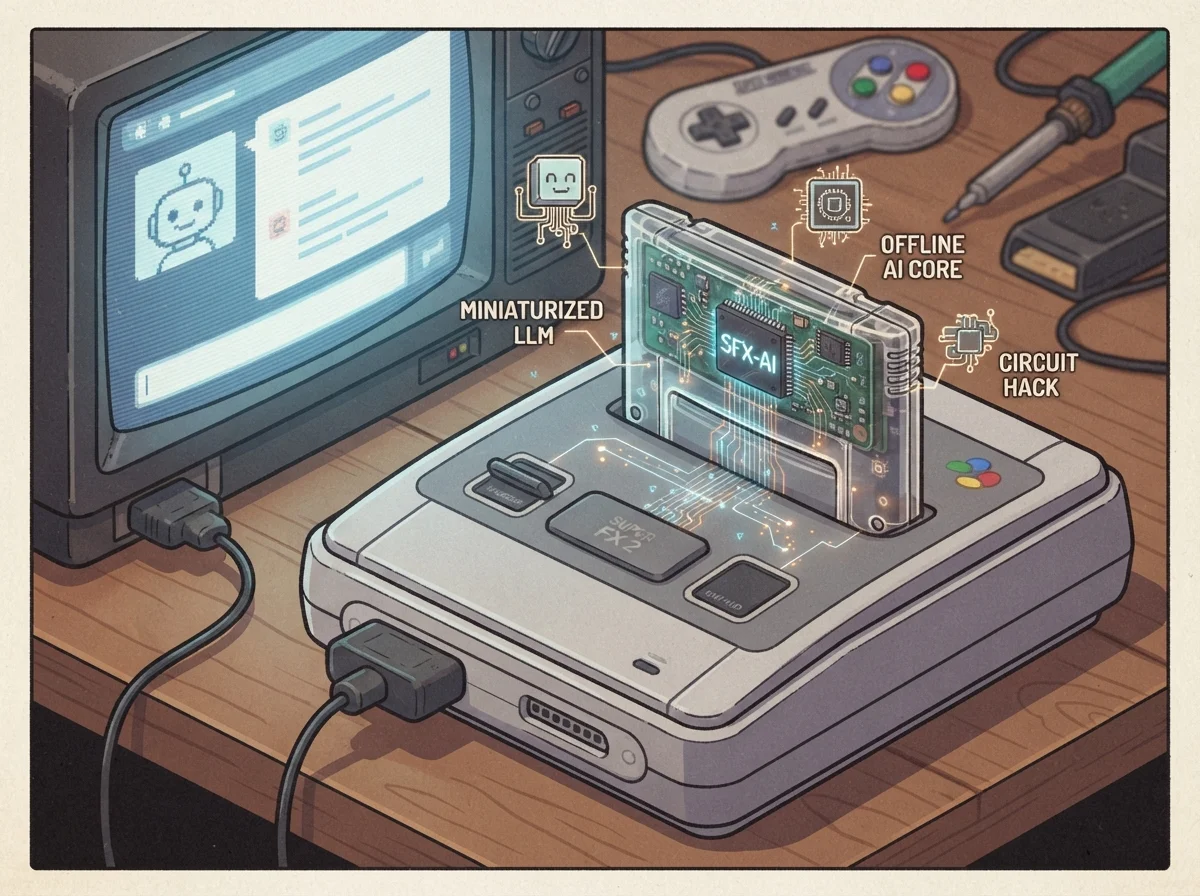
Vintage Computingプラットフォームの創設者である開発者のBenj Edwardsは、インターネット接続や外部サーバーを一切必要とせずに、Super Nintendo (SNES)のハードウェア上で機能的な言語モデルを実行できることを実証しました。このプロジェクトは、Super FX 2コプロセッサを使用して、ChatGPTにインスパイアされたチャットボットのやり取りを処理し、1990年代のビデオゲームを自律的な会話ターミナルとして機能させています。
この発見は、言語モデル圧縮の極限的な限界と、「エッジ」技術の実現可能性を示しているため重要です。エッジ技術とは、処理がユーザーの最終デバイス、つまり「端」で実行されることを指します。ほとんどの人がAIツールにアクセスするために大規模なデータセンターに依存している状況において、この実験は、ソフトウェアがメモリとクロックスピードの厳しい制約に対応するように適切に最適化されていれば、たとえ古い電子部品であっても十分な計算能力を持っていることを証明しています。
オフラインチャットの背後にある技術的アーキテクチャ
これを可能にするために、Super FX 2チップが使用されました。このコンポーネントは元々、Silicon Graphicsによって開発され、基本的な3Dレンダリングのような複雑な数学的タスクでコンソールを補助するために設計されました。これは21.47 MHzの周波数で動作するため、極めて軽量な人工知能モデルが必要となります。Edwardsは、わずか220万のパラメータからなる小さな言語モデルを使用しました。「パラメータ」とは、機械がどのように応答するかを決定する人工ニューラル接続として理解してください。これらを、文章のトーンや方向性を決定する小さな調整ノブのようなものだと想像してください。
この特定のモデルのトレーニングは、OpenAIのgpt-oss-120bによって生成された会話に基づいて行われました。しかし、古いハードウェアの制約のため、そのスケールは劇的に縮小されています。最新のモデルが数十億または数兆のパラメータで動作するのに対し、このバージョンはシステムに収まるために数千分の1に小さくなる必要があります。この圧縮の結果、1秒あたり約2単位のテキストを生成することが可能になります。これは現在の標準と比較すると遅い速度ですが、関与しているプロセッサの歴史的文脈を考慮すると、技術的には非常に意義深いものです。
ユーザー体験と利用可能なバージョン
現在、この実験はSnes9xを使用したウェブエミュレーターを通じてテストすることができ、ユーザーはキーボードを介して操作します。このプロジェクトには2つの複雑性のレベルがあります。一つは言語モデルのロジックのみを含む4MBのベーシックバージョン、もう一つは19MBの拡張バージョンです。後者のオプションは、簡易英語に翻訳された約15万件のWikipediaの記事から抽出された情報を統合しており、AIがユーザーへの回答を生成する前に、より多くの事実データにアクセスできるようにしています。
オリジナルの物理コンソールをお持ちの方の場合、このソフトウェアはSuper FX 2チップに対応したフラッシュカートリッジ、そして拡張バージョンでは追加メモリ管理を補助するMSU-1チップを介して実行することも可能です。インターフェースは1990年代の特徴的なレトロな美学を維持しており、クラシックな効果音やチップチューン(古いコンソールのサウンドチップによって特別に作曲された音楽)スタイルの楽曲を含み、視覚的および聴覚的な体験を新しい技術的機能と統合しています。
システムの制限と最新モデルとの比較
この実装がChatGPTやGeminiの最新バージョンの能力を置き換えるものではないことを強調しておくことが重要です。パラメータが少ないため、このチャットボットは非常に単純な回答を返す傾向があり、複雑なニュアンスを処理するための計算上の「認知空間」が不足しているため、しばしば不条理または一貫性のない発言を生成します。広範なコンテキストを同時に分析する現在のシステムとは異なり、このモデルは多面的な問題を解決できるインテリジェントなアシスタントというよりも、高度に洗練されたオートコンプリートとして機能します。
モデルが毎秒数十億回の演算を処理できる強力なGPU上で実行される現在の標準と比較すると、SNESバージョンは徹底的な小型化に焦点を当てた工学的な試みです。これは実用的な生産性ツールというよりも、人工知能のモジュール性に関するコンセプト証明として機能します。この実験は、精度と速度を犠牲にすることで、基本的な認知機能を最小限の論理処理能力を持つあらゆるハードウェアに移植できることを示しています。
リミテッドデバイスにおけるAIの将来的な展望
長期的には、このような開発は、プライバシーと効率性を追求する傾向の高まりを示しています。それは、クラウドを必要とせず、小型電子デバイス上でローカルAIを実行することです。量子化技術(ニューラルネットワークの数値精度を下げてメモリを節約するプロセス)が進化するにつれて、家電や古いウェアラブルに統合されたアシスタントの機能的なバージョンが、完全にオフラインで動作するようになるかもしれません。現時点では、Ben Edwardsのプロジェクトは、魅力的な技術的興味であり、極限の最適化の教訓として残っています。